TechTalkThai ศูนย์รวมข่าว Enterprise IT ออนไลน์แห่งแรกในประเทศไทย








iApp เปิดตัว OpenThai-SystemOne โมเดลตัดสินใจแบบ System One ภาษาไทย-อังกฤษ โอเพนซอร์ส: 0.8B พารามิเตอร์ สัญญาอนุญาต Apache 2.0 น้ำหนักโมเดลและสูตรการเทรนอยู่บน Hugging Face และ GitHub พร้อม API แบบโฮสต์ใช้ฟรีบน api.iapp.co.th
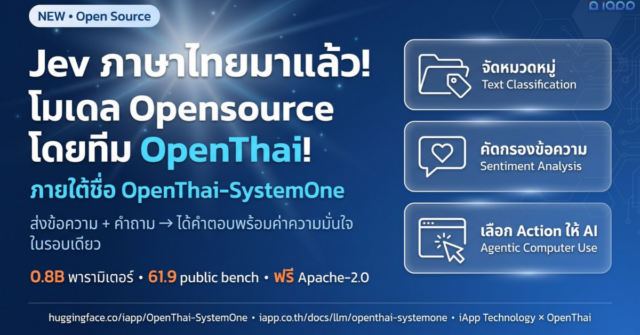
โมเดลนี้ไม่เขียน แต่ตัดสินใจ ส่ง state และคำถามเชิงโครงสร้างให้ แล้วได้ความน่าจะเป็นที่ปรับเทียบแล้วของทุกตัวเลือกในทุกคำถามในการคำนวณรอบเดียว โดยไม่มีโทเคนขาออกเลย
หน้าโมเดล: iapp.co.th/openmodels/openthai-systemone · น้ำหนักโมเดล: huggingface.co/iapp/OpenThai-SystemOne · โค้ด: github.com/iapp-technology/openthai-systemone · ลองใช้: หน้า API
ทำไมต้องมีโมเดลที่ไม่สร้างข้อความ
ธุรกิจไทยจัดเส้นทาง ticket คัดกรองคอมเมนต์ เลือกปุ่มถัดไปให้ agent กด และตรวจว่าคำตอบอ้างอิงข้อมูลจริงหรือไม่ วันละหลายล้านครั้ง แต่ละครั้งคือการตัดสินใจระหว่างตัวเลือกที่รู้อยู่แล้ว การเรียกโมเดลภาษาขนาดใหญ่ทุกครั้งทั้งช้า เสียโทเคน และอาจตอบสิ่งที่ไม่เคยอยู่ในรายการตัวเลือก
โมเดล System One ตอบคำถามเชิงโครงสร้างโดยตรง TypeSafe AI เปิดหมวดนี้ด้วย Jev เมื่อ 15 กันยายน 2569 ห้าวันต่อมา นี่คือเวอร์ชันเปิดสำหรับภาษาไทยและอังกฤษ พร้อมสิ่งที่ TypeSafe ไม่เปิดเผย นั่นคือสถาปัตยกรรม
โมเดลทำอะไรได้
คุณให้ state (ข้อความหรือ JSON อะไรก็ได้) และ คำถาม หนึ่งข้อขึ้นไปจากสามประเภท:
| ประเภท | คุณให้ | คุณได้ |
|---|---|---|
choice | คำสั่งและตัวเลือกที่ตั้งชื่อไว้สูงสุด 255 ตัวเลือก | ตัวเลือกที่ดีที่สุด ความน่าจะเป็นต่อตัวเลือก confidence และ abstain |
score | คำสั่งและระดับเรียงลำดับ 2 ถึง 10 ระดับ | คะแนนถ่วงน้ำหนักด้วยความน่าจะเป็น และความน่าจะเป็นต่อระดับ |
noul | คำถามใช่/ไม่ใช่ | P(ใช่) |
ทุกคำถามถูกตอบในการคำนวณรอบเดียวกัน ตัวอย่าง ticket ฝ่ายสนับสนุนภาษาไทยพร้อมสามคำถาม และผลลัพธ์ที่วัดได้จริงจากโมเดล:
{"state": {"ticket": "โดนหักเงินซ้ำสองครั้งเมื่อวานนี้ ขอเงินคืนด่วนนะครับ โทรไปสามรอบแล้วไม่มีใครรับ"},
 "questions": {
   "department":  {"type": "choice", "instructions": "ทีมใดควรรับผิดชอบ",
                   "criteria": {"billing": "การเงิน/คืนเงิน", "technical": "ระบบใช้งานไม่ได้", "sales": null}},
   "frustration": {"type": "score", "instructions": "ลูกค้าหงุดหงิดแค่ไหน",
                   "criteria": ["ใจเย็น", "หงุดหงิดแต่สุภาพ", "โกรธมาก"]},
"refund": {"type": "noul", "instructions": "ลูกค้าขอเงินคืนอย่างชัดเจนหรือไม่"}}}| คำถาม | คำตอบ | ความมั่นใจ |
|---|---|---|
| department | billing (96.3%), technical 1.1%, sales 2.6% | 0.83 |
| frustration | 1.95 จาก 2 (โกรธมาก 95.7%) | 0.82 |
| refund | P(ใช่) = 0.946 |
166 โทเคนขาเข้า 0 โทเคนขาออก ไป-กลับผ่านเกตเวย์ของเรา 0.23 วินาที
ทำงานอย่างไร
เรานำส่วนประมวลผลข้อความของ Qwen3.5-0.8B มาเทรนต่อด้วยข้อความไทยราว 5 พันล้านโทเคน แล้วเปลี่ยนหัวโมเดลภาษาขนาด 248K คำเป็นหัวตัดสินใจ 256 ช่อง ตัวเลือกถูกแนะนำด้วยโทเคนควบคุม ทุกตำแหน่งคำตอบถูกฉายเป็น 256 logit ช่องที่เกินจำนวนตัวเลือกถูกปิด และช่อง 255 หมายถึง “ไม่มีตัวเลือกใดเหมาะ” choice ใช้ค่าสูงสุด score คือดัชนีระดับถ่วงน้ำหนักด้วยความน่าจะเป็น noul คือความน่าจะเป็นของคำตอบใช่ ลำดับตัวเลือกถูกสลับระหว่างเทรน จึงไม่มีอคติตามตำแหน่ง โมเดลเทรนด้วยชุดข้อมูลสาธารณะด้านการจัดหมวดหมู่ NLI ถาม-ตอบ และ agent รวมกับงานตัดสินใจภาษาไทยและอังกฤษที่สังเคราะห์ขึ้น แล้วผ่านการปรับเทียบ
ผลคือโมเดลที่รันบน GPU โน้ตบุ๊กได้: 154 มิลลิวินาทีต่อคำขอบน MacBook M3 Max และ 40 ถึง 70 มิลลิวินาทีบน H100
ข้อจำกัด บอกไว้ก่อนเลย
- นี่คือเวอร์ชัน 0.1 และเป็นโมเดลขนาด 0.8B ไม่ใช่โมเดลคิดวิเคราะห์
- ตอบได้เฉพาะตัวเลือกที่ให้ แต่ยังเลือกผิดได้ ทุกคำตอบมีค่า confidence ส่งเคสที่ค่าต่ำไปโมเดลใหญ่หรือคน
- รับข้อความอย่างเดียว
- สูงสุด 255 ตัวเลือกต่อ choice, 2 ถึง 10 ระดับต่อ score, 64K โทเคนต่อคำขอ
ตัวเลข
อัปเดต 22 กันยายน 2569: v0.3
อัปเดตสองครั้งหลังเปิดตัว v0.2 (21 กันยายน) เพิ่มชุดข้อมูลความรู้สึกโซเชียลไทยสังเคราะห์ 22,000 รายการ: macro 61.9 เป็น 63.2, Wisesight 38.7 เป็น 51.5 v0.3 (22 กันยายน) เทรนต่ออีก 5,000 สเต็ปด้วยชุดเทรนจริงและชุดสังเคราะห์เฉพาะทางห้าชุดสำหรับจุดอ่อน: macro 63.2 เป็น 74.3 ห่างจาก Bespoke-Nimble-9B (74.8) เพียง 0.5 คะแนน, SQuAD2 50.2 เป็น 89.3, PAWS 68.0 เป็น 94.0, Aegis2 61.6 เป็น 83.2 โดยมีจุดถดถอยหนึ่งจุด (ความสอดคล้องของบทสรุป SummEval 84.0 เป็น 75.0) และมีโหมดไม่ขึ้นกับลำดับตัวเลือก ซึ่งตัดความไวต่อลำดับตัวเลือกที่โมเดลแบบคำนวณรอบเดียวมีเหมือน Jev API แบบโฮสต์และน้ำหนักบน Hugging Face เป็น v0.3 แล้ว ตารางด้านล่างอัปเดตตามนั้น
บน public benchmark 13 ชุดของ Bespoke Labs สำหรับโมเดล System One ใช้ชุดข้อมูล การแบ่ง คำสั่ง และตัวสุ่มเดียวกับที่ Bespoke เผยแพร่ โมเดล 0.8B ของเราได้ค่าเฉลี่ย macro 74.3 (v0.3) ส่วน Bespoke-Nimble-9B ได้ 74.8 และ Jev 1.13.0 ได้ 76.0 ตัวหนาคือชุดที่โมเดล 0.8B นำโมเดล 9B
| Subset | Type | n | OpenThai-SystemOne 0.8B | Nimble-9B | Jev 1.13.0 |
|---|---|---|---|---|---|
| aegis2 | noul | 250 | 83.2 | 81.2 | 80.4 |
| boolq | noul | 300 | 79.7 | 86.0 | 89.7 |
| civil_comments | noul | 300 | 79.0 | 70.3 | 81.0 |
| helpsteer2 | score | 250 | 41.6 | 39.0 | 34.1 |
| massive-de-DE | choice | 350 | 88.3 | 83.4 | 86.9 |
| massive-en-US | choice | 350 | 88.3 | 86.9 | 87.4 |
| multinli | choice | 299 | 89.0 | 85.3 | 82.9 |
| paws | noul | 250 | 94.0 | 82.8 | 89.2 |
| pubmedqa | choice | 250 | 64.0 | 75.6 | 77.2 |
| squad2 | noul | 299 | 89.3 | 80.6 | 82.9 |
| summeval-consistency | score | 144 | 75.0 | 75.7 | 81.2 |
| summeval-relevance | score | 240 | 21.7 | 49.2 | 35.0 |
| vitaminc-dev | choice | 599 | 72.5 | 76.6 | 80.1 |
| Macro average | 74.3 | 74.8 | 76.0 |
เราอยากให้อ่านรายแถวมากกว่าดูค่าเฉลี่ย v0.3 นำโมเดล 9B ใน 8 จาก 13 ชุด (paraphrase, ความปลอดภัย, NLI, ชุด intent MASSIVE ทั้งสอง, ข้อความเป็นพิษ, การให้คะแนนความช่วยเหลือ, ใช่/ไม่ใช่แบบดึงคำตอบ) และตามหลังใน PubMedQA, VitaminC และงานให้คะแนนบทสรุปสองงาน ซึ่งความเกี่ยวข้องยังอ่อนที่สุด ตั้งแต่ v0.3 ชุดเทรนของ SQuAD2, BoolQ, PubMedQA, PAWS, Aegis2 และ MASSIVE-de อยู่ในข้อมูลเทรน โดย benchmark ใช้เฉพาะชุด validation และ test บนชุดทดสอบภาษาไทยที่ไม่เคยใช้เทรน ได้ 90.0 บนเจตนา 60 หมวดของ MASSIVE-th, 98.1 บนหัวข้อ Prachathai, 77.1 บน XNLI-th และ 77.9 บน SIB-200 ภาษาไทย โดยค่าความคลาดเคลื่อนของการปรับเทียบไม่เกิน 0.05 ในชุดส่วนใหญ่ และสองชุดที่อ่อนที่สุดคือความรู้สึก Wisesight (51.6) และเจตนา 77 หมวดของ banking77 (45.4) ตารางทั้งหมดพร้อม ECE และ Brier score รายชุดข้อมูล และการเปรียบเทียบก่อน/หลังปรับเทียบ อยู่ในmodel card
เริ่มต้นใช้งาน
แบบโฮสต์ พรีวิวฟรี endpoint POST https://api.iapp.co.th/v3/store/openthai/systemone ใช้ฟรีด้วย iApp API key ใดก็ได้ (สมัครฟรี) จำกัด 1,000 การตัดสินใจต่อวันต่อ key ราคาต่อการตัดสินใจจะประกาศในเดือนตุลาคม 2569 หน้า API มีสนามทดลองพร้อมตัวอย่างสี่แบบ โค้ด cURL, Python และ JavaScript และรายละเอียดคำขอ-คำตอบครบถ้วน รูปแบบคำขอเหมือน POST /v1/systemone โค้ดที่เขียนไว้สำหรับ API นั้นจึงใช้ได้ทันที
บนเครื่องของคุณ
pip install "git+https://github.com/iapp-technology/openthai-systemone"
OPENTHAI_SYSTEMONE_MODEL=iapp/OpenThai-SystemOne uvicorn openthai_systemone.server:app --port 8000
ทุกอย่างเปิดภายใต้ Apache 2.0: น้ำหนักโมเดล สคริปต์เทรน คอนฟิก และข้อมูลสังเคราะห์ เรายินดีรับความช่วยเหลือเรื่องการแปลงเป็น GGUF และ MLX (หัวโมเดลเป็น linear layer ธรรมดา) และชุดทดสอบภาษาไทยและอังกฤษที่เรายังไม่มี ส่ง issue หรือ pull request มาที่ GitHub ได้เลย
OpenThai-SystemOne เข้าร่วมครอบครัว OpenThai 2.0 กับ OpenThai 2.0 และ OpenThai 2.0 Legal