TechTalkThai ศูนย์รวมข่าว Enterprise IT ออนไลน์แห่งแรกในประเทศไทย











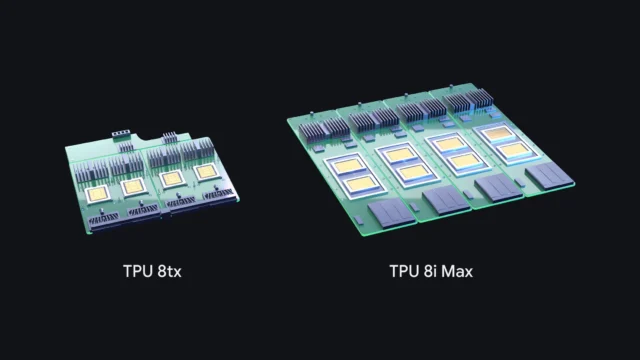
Google เปิดตัว TPU 8tx และ TPU 8i Max ระบบใหม่ในตระกูล TPU รุ่นที่ 8 โดย TPU 8tx เน้นงาน inference ที่ต้องปกป้องข้อมูลในระดับฮาร์ดแวร์ ส่วน TPU 8i Max รวมชิป TPU 8i จำนวน 2 ตัวไว้ในแพ็กเกจเดียวเพื่อรองรับ context window ขนาดใหญ่
ก่อนหน้านี้ Google ได้เปิดตัว TPU 8t สำหรับการฝึกโมเดลขนาดใหญ่ และ TPU 8i สำหรับงาน reasoning แบบ real-time ในงาน Google Cloud Next เมื่อเดือนเมษายน โดย TPU 8t ให้ประสิทธิภาพการฝึกโมเดลดีขึ้นสูงสุด 2.7 เท่า และ TPU 8i ให้ price performance ด้าน inference ดีขึ้น 80% เมื่อเทียบกับ TPU รุ่นก่อน การเพิ่ม TPU 8tx และ TPU 8i Max ทำให้ปีนี้ Google เปิดตัวระบบ TPU รวม 4 ระบบ ซึ่งเป็นครั้งแรกที่ทำได้ภายในปีเดียว ปัจจุบันธุรกิจ TPU มีลูกค้าเกือบ 100 ราย ทั้ง frontier lab บริษัทเทรด ธุรกิจค้าปลีก และมหาวิทยาลัย และลูกค้าสามารถนำ TPU ไปติดตั้งใน data center ของตนเองได้แล้ว ระบบใหม่ทั้งสองไม่ได้ใช้ชิปใหม่ แต่เป็นการจัดองค์ประกอบด้าน compute, networking, storage และ packaging รอบชิปเดิมใหม่ ซึ่ง Google ระบุว่าทำให้ส่งมอบระบบเฉพาะทางได้ในระยะเวลาหลักเดือนแทนหลักปี
TPU 8tx สร้างบนซิลิคอนเดียวกับ TPU 8t และทำงานคู่กับ CPU host แบบ AMD EPYC รุ่นที่ 5 ออกแบบมาสำหรับงาน confidential inference ขององค์กรในอุตสาหกรรมที่มีการกำกับดูแลเข้มงวดและหน่วยงานภาครัฐที่ต้องรันโมเดลและ AI Agent ร่วมกับข้อมูลอ่อนไหว โดยปกติข้อมูลจะถูกเข้ารหัสระหว่างจัดเก็บหรือส่งผ่านเครือข่าย แต่ต้องถอดรหัสในหน่วยความจำขณะประมวลผล TPU 8tx จึงฝังความสามารถด้านความปลอดภัยไว้ในระดับฮาร์ดแวร์ เพื่อปกป้องและแยกข้อมูลรวมถึง model weights ไว้แม้ในระหว่างการประมวลผล ระบบยังใช้เครือข่าย Boardfly แบบ low-latency เดียวกับ TPU 8i ทำให้ latency ต่ำกว่า TPU 8t สูงสุด 2 เท่าโดยแทบไม่กระทบประสิทธิภาพ องค์กรจึงสามารถใช้ระบบเดียวทั้ง fine-tune โมเดลด้วยข้อมูลภายใน distill โมเดลใหญ่ให้เป็นโมเดลเล็ก และฝึก Agent ด้วย reinforcement learning ได้โดยไม่ต้องย้ายข้อมูลอ่อนไหวข้าม cluster
ส่วน TPU 8i Max มุ่งแก้ปัญหา memory wall ที่เกิดขึ้นเมื่อ AI Agent หลายสิบตัวทำงานร่วมกันบน codebase ทั้งหมดหรือวิดีโอความยาวหลายชั่วโมง จนแบนด์วิดท์หน่วยความจำกลายเป็นคอขวด Google จึงรวมชิป TPU 8i จำนวน 2 ตัวไว้ในแพ็กเกจเดียว ทำให้ได้ compute, SRAM และ HBM bandwidth เป็น 2 เท่าของ TPU 8i และเนื่องจากใส่ซิลิคอนได้มากขึ้นเท่าตัวในพื้นที่แร็คเดิม data center จึงได้กำลังประมวลผลต่อตารางฟุตและต่อวัตต์สูงขึ้น เมื่อรวมกันแล้ว TPU รุ่นที่ 8 จะแบ่งบทบาทออกเป็น 4 ระบบ ได้แก่ TPU 8t สำหรับการฝึกโมเดล TPU 8i สำหรับ reasoning แบบ low-latency TPU 8tx สำหรับ confidential computing และ TPU 8i Max สำหรับ context window ขนาดใหญ่และความหนาแน่นของ compute ต่อแร็คสูงสุด
ฝั่งซอฟต์แวร์ Google ได้เปิด TorchTPU เป็น open source ให้โค้ด PyTorch และโมเดลจาก Hugging Face รันบน TPU ได้โดยตรงโดยไม่ต้องแก้โค้ด พร้อม backend สำหรับ vLLM และ SGLang นอกจากนี้ยังมี TPU agent suite แบบ open source (preview) ที่ทำงานร่วมกับ Claude Code, Cursor และ Google Antigravity เพื่อช่วยให้เริ่มใช้งาน TPU ได้ภายในไม่กี่นาที วิเคราะห์คอขวด และ autotune custom kernel ด้วยภาษาธรรมชาติ ขณะที่ XLA Serving Engine ช่วยให้ฝึกโมเดลด้วย Python แล้วนำไป serve บน runtime ภาษา C++ ได้ทั้งบน TPU, GPU และ CPU ส่วน Agent Compute Engine จะ suspend และ resume session ของ Agent ที่หยุดรอการตอบกลับโดยอัตโนมัติเพื่อลดต้นทุนโครงสร้างพื้นฐาน
สำหรับการบริหาร cluster ขนาดใหญ่ Google เปิด TPU Sync เป็น open source ซึ่งรวม HBM ของชิป, DRAM ของ host, shared storage และเครือข่ายใน data center เป็นลำดับชั้นหน่วยความจำเดียว ช่วยลด latency ในการส่ง KV cache และ Time to First Token (TTFT) ได้มากกว่า 90% ขณะที่ Cloud Pathways เปิดให้ใช้งานทั่วไป (GA) บน Google Kubernetes Engine (GKE) แล้ว ช่วยควบคุม TPU หลาย slice จาก controller เดียวเสมือนเป็นเครื่องเดียว และ GKE dynamic slicing ซึ่ง GA แล้วเช่นกัน ใช้ optical circuit switching (OCS) ประกอบหรือแบ่ง TPU slice ได้ทันทีโดยไม่ต้องสร้าง nodepool ใหม่ ช่วยให้เริ่มงานได้เร็วขึ้นสูงสุด 5 เท่าและกู้คืนจากความผิดพลาดได้เร็วขึ้นสูงสุด 4.5 เท่า
ที่มา: https://blog.google/innovation-and-ai/infrastructure-and-cloud/global-network/tpu-8i-max-and-8tx/